Technology
予備知識は、いりません。デモの裏側で何が起きているのかを、図と映像でひとつずつ紐解いていきます。
Big Picture
Physical AIは、カメラで見て、AIが考えて、ロボットの体で動くシステムです。このカタログの2つのデモは同じAWSの部品でできていますが、「考える」をクラウドに置くか、エッジ(ロボットのそば)に置くかが違います。まず、その2つのかたちをそのまま図にしました。
Stack 01 — VLA
VLA(Vision-Language-Action)は、カメラ映像(Vision)と言葉の指示(Language)を入力すると、ロボットの動き(Action)を出力するAIモデル。ChatGPTのようなAIが「言葉」を返すかわりに、「関節の角度の列」を返すと考えるとわかりやすいです。

カメラ画像(俯瞰+手先)、「消しゴムを片付けて」という指示、いまの関節角度

学習した経験から「この状況ならこう動く」を推論。数十ステップ先までの動きをまとめて生成(Action Chunking)

各関節の目標角度の列。これを毎秒何十回も繰り返して、なめらかな動作になる
どのモデルも「見る → 理解する → 動きを生成する」の3段構成が基本で、違いは規模と得意分野。しまってAIチームは4モデルを実機で並行検証し、本番には確実性で選びました。
タスク特化の軽量モデル。一連の動きをまとめて予測するAction Chunkingで小さな物体の精密把持が得意。
本番ブースのライブデモは、3タスクを1つのACTモデルで実演
Image: Hugging Faceコード・重み・学習データまでApache 2.0で公開。手元のGPUでも動かせる規模で、始める1台目に最適。
AWS上に構築した検証環境でも学習・実機推論を実践
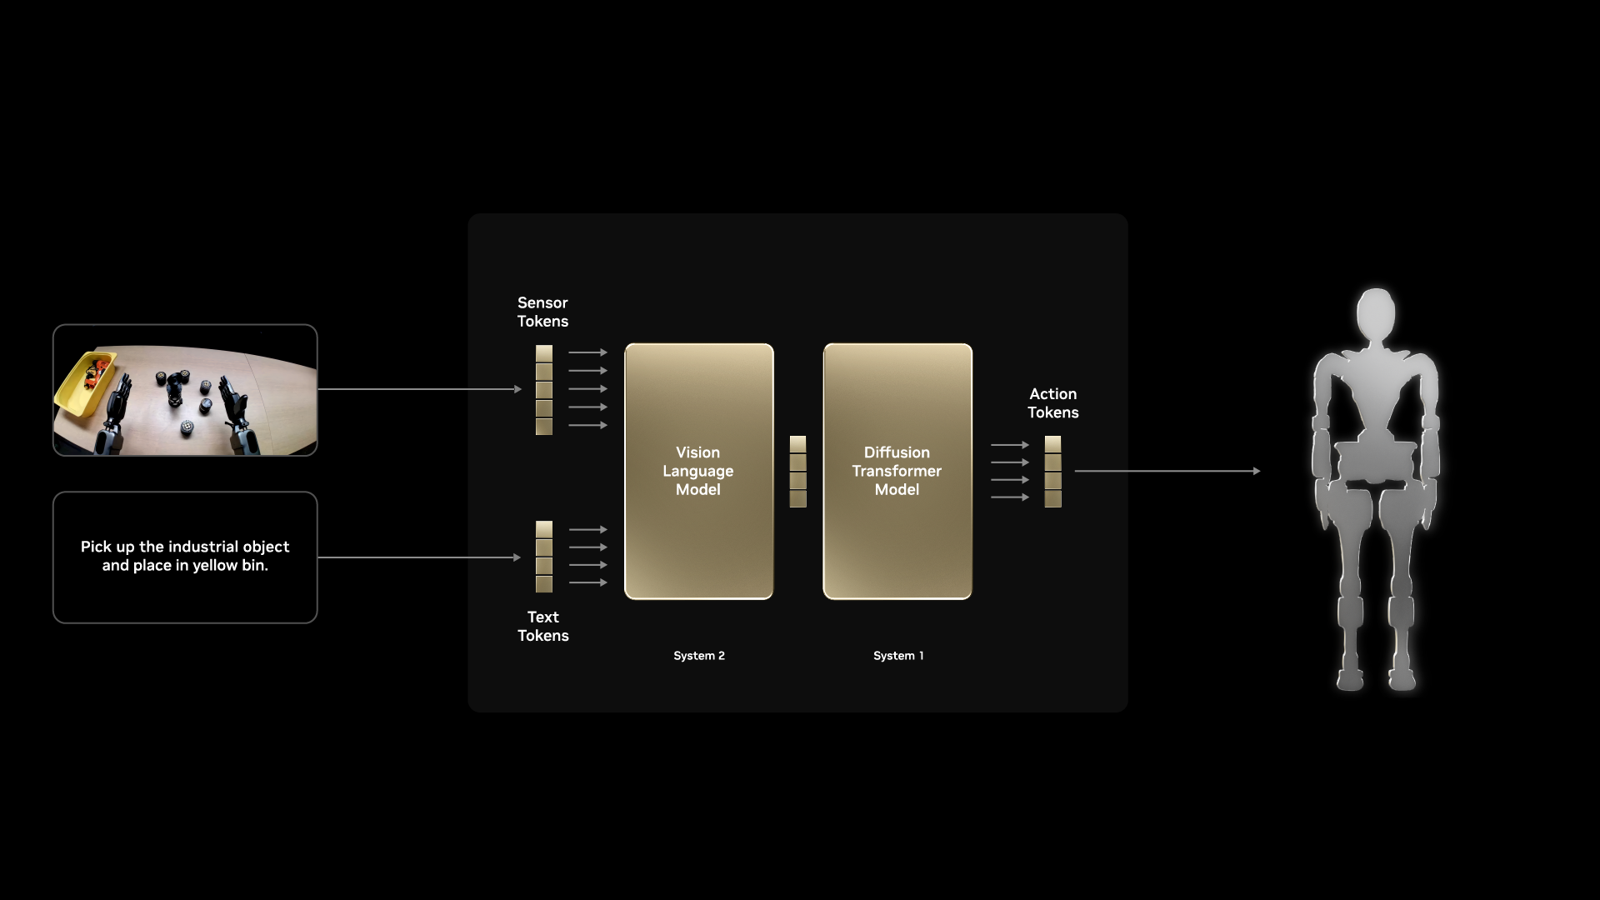
Image: NVIDIANVIDIAのロボット基盤モデルファミリー。System1/System2の2層設計で「反射」と「思考」を分担。
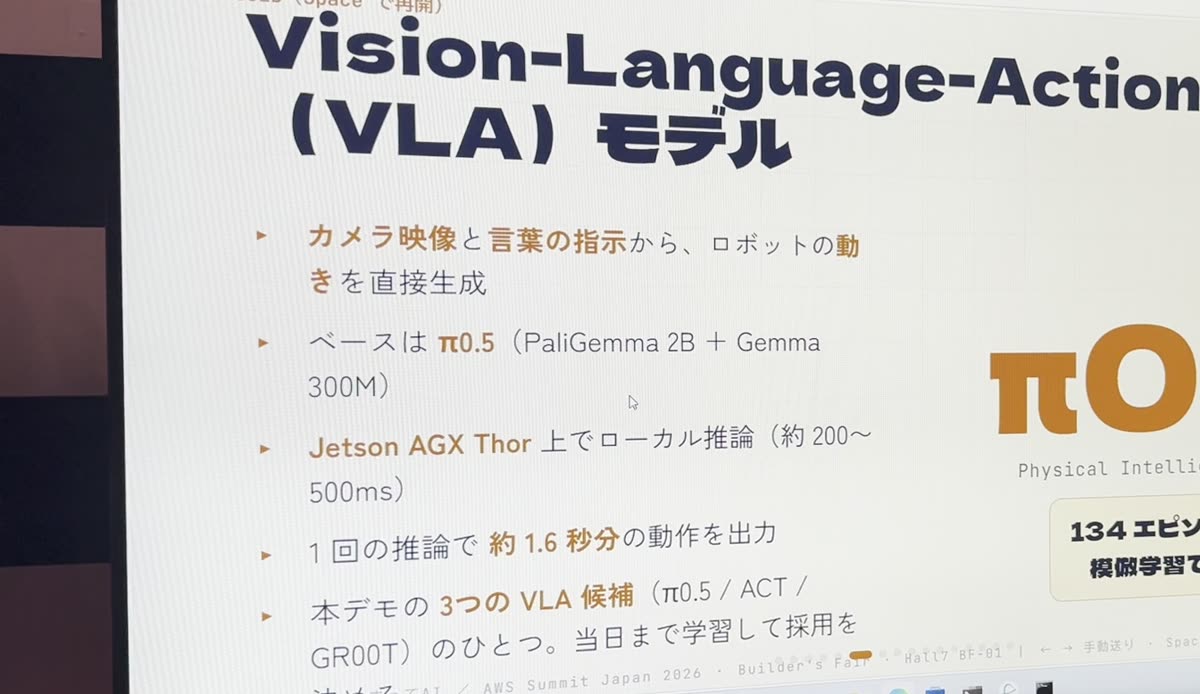
しまってAIではペンの把持タスクを実機検証PaliGemma 2B + Gemma 300Mベースの大型モデル。初めて見る配置にも対応する汎化力が持ち味。
しまってAIでは134エピソードで学習し、3タスクを実機検証Stack 02 — Physical AI Ops
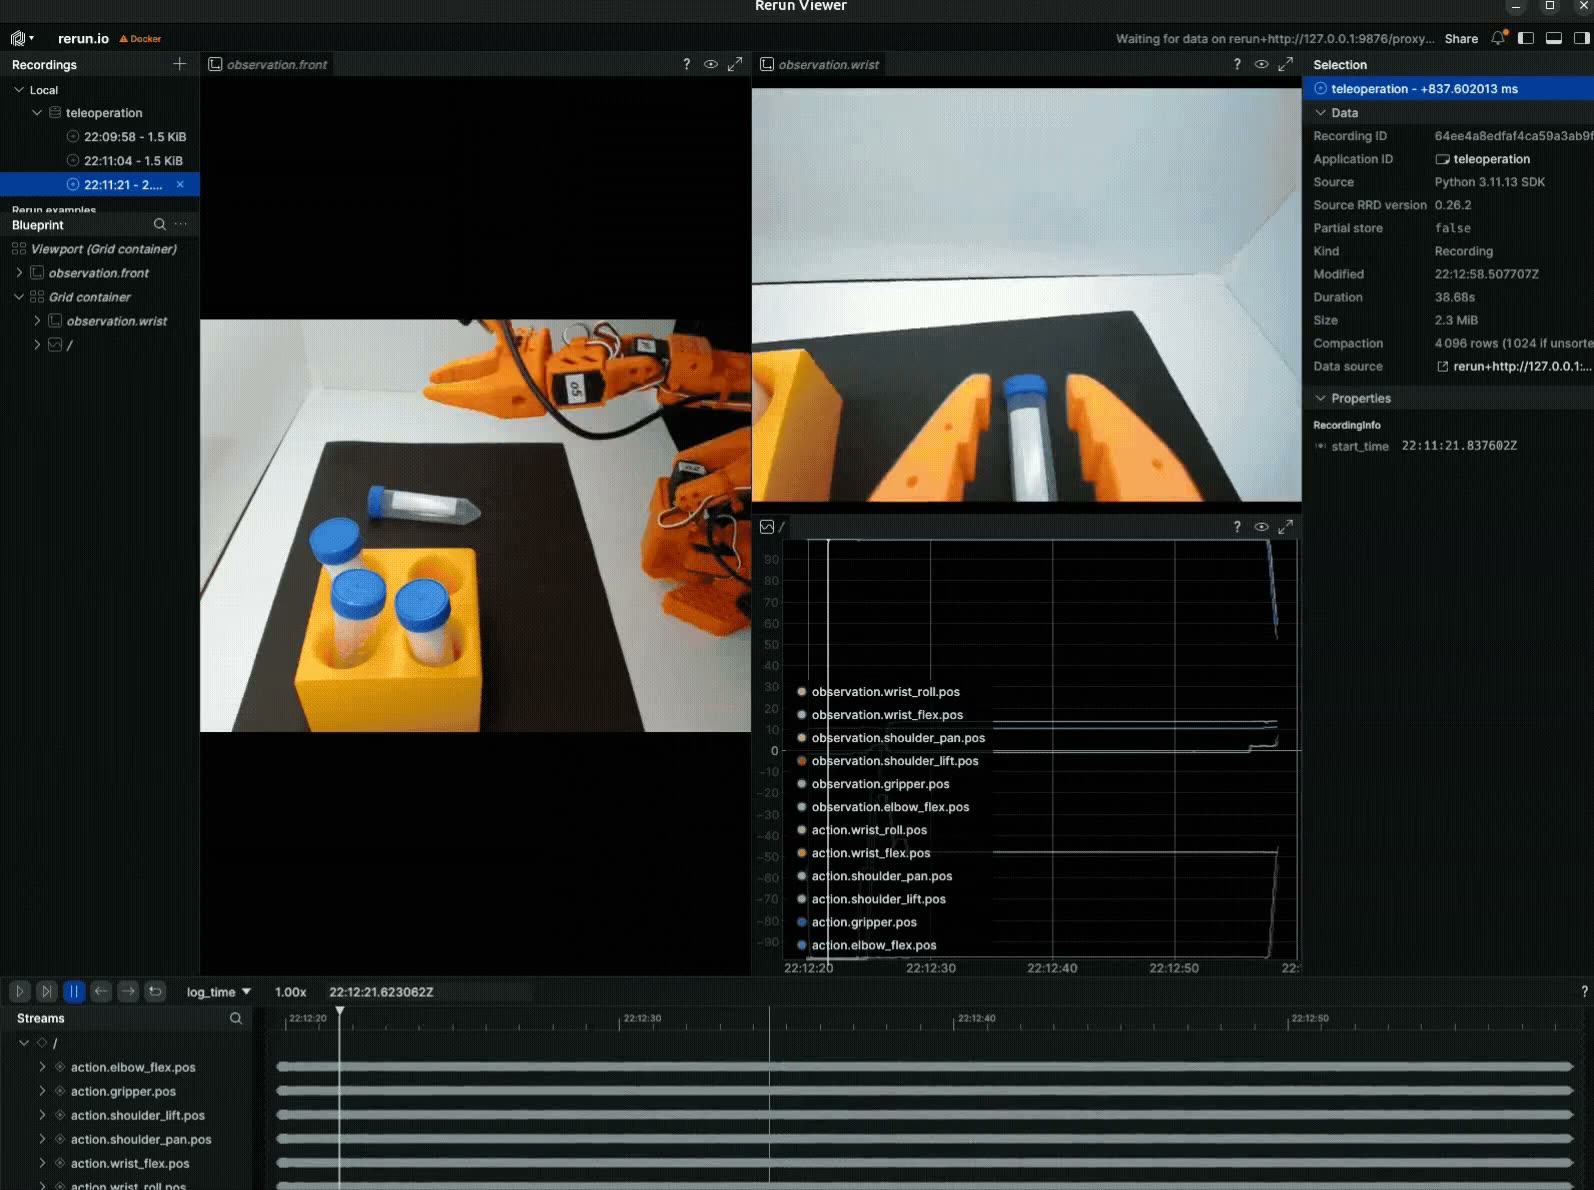
VLAモデルは、人がお手本を見せる「模倣学習」で育ちます。現場を写し取り(収集)、仮想空間で増やし(生成)、クラウドで鍛え(学習)、シミュレータと実機で測る(評価)。足りないデータが見つかったら、また収集へ — このサイクルを何周も回して精度を上げるのが、ロボット版のMLOpsです。
Stack 03 — Sim2Real
実機でのデータ収集は手間がかかります。そこで、実機とそっくりな仮想空間(NVIDIA Isaac Sim)をクラウドGPU上に構築し、お手本データの自動生成や学習前の検証を行います。このGPU環境は、AWSがGitHubで公開しているサンプル実装 Remote AWS Development Station を使って、コーディングエージェント入りの開発環境ごと必要なときに立ち上げています。見た目や物理の「仮想と現実のギャップ」は、カメラ校正(ChArUco)や、条件をあえてランダムに変える学習でならしていきます。
Stack 04 — Edge
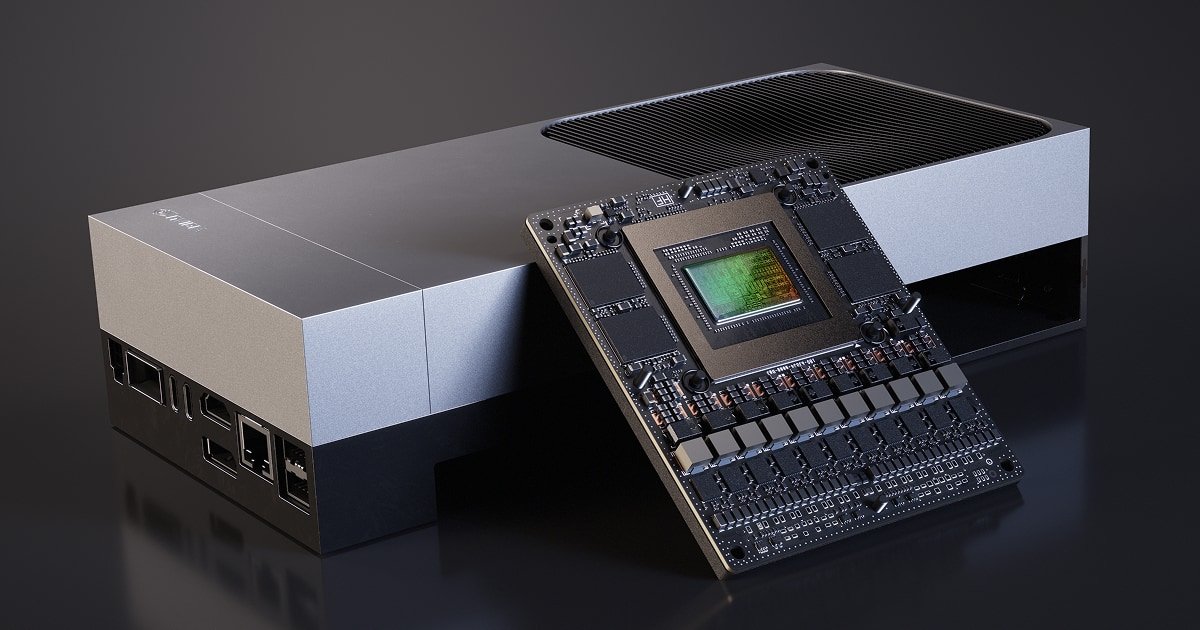
Image: NVIDIAしまってAIのVLA推論を担うのは、手のひらサイズのAIコンピュータ。カメラ映像から関節の動きを計算するループを、ネットワークを介さずローカルで回すため、通信遅延の影響を一切受けません。学習済みモデルはクラウド(Amazon S3)からAWS Systems Manager経由で配信され、現場のコンピュータが受け取って動き出します。
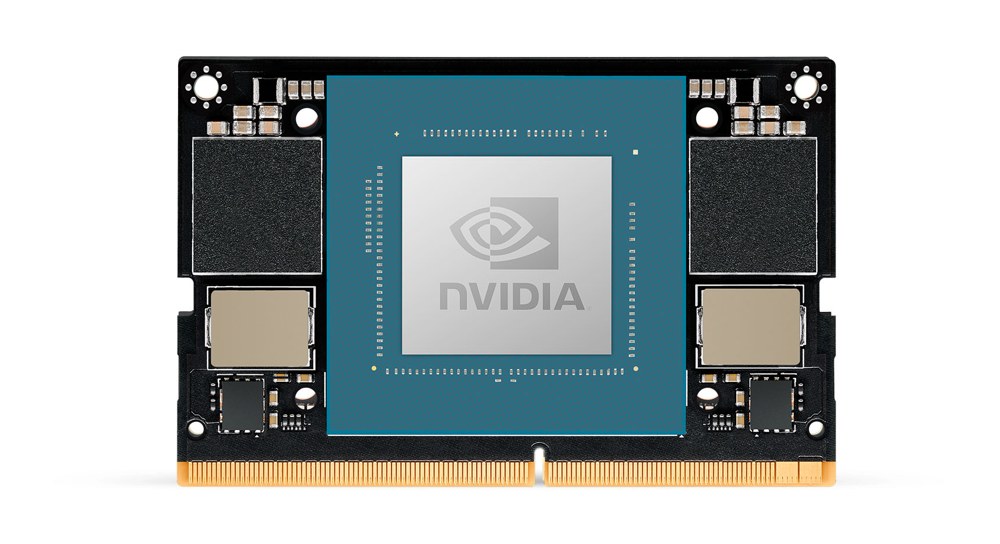
Image: NVIDIA必ずしも大型GPUは要りません。手のひらサイズ・低消費電力(7〜25W)のこの開発キットで、実際にVLAの実機推論も行っています。まず小さく始めるのに十分な頭脳です。
Stack 05 — Remote Ops
ある日の一周は、こんな流れです。⑧までいくと、また①へ — 一周まわすたびに、ロボットは確実に賢くなります。

ループが一周まわるたび、できることが増えていく。4本の映像は、その積み重ねの記録です。
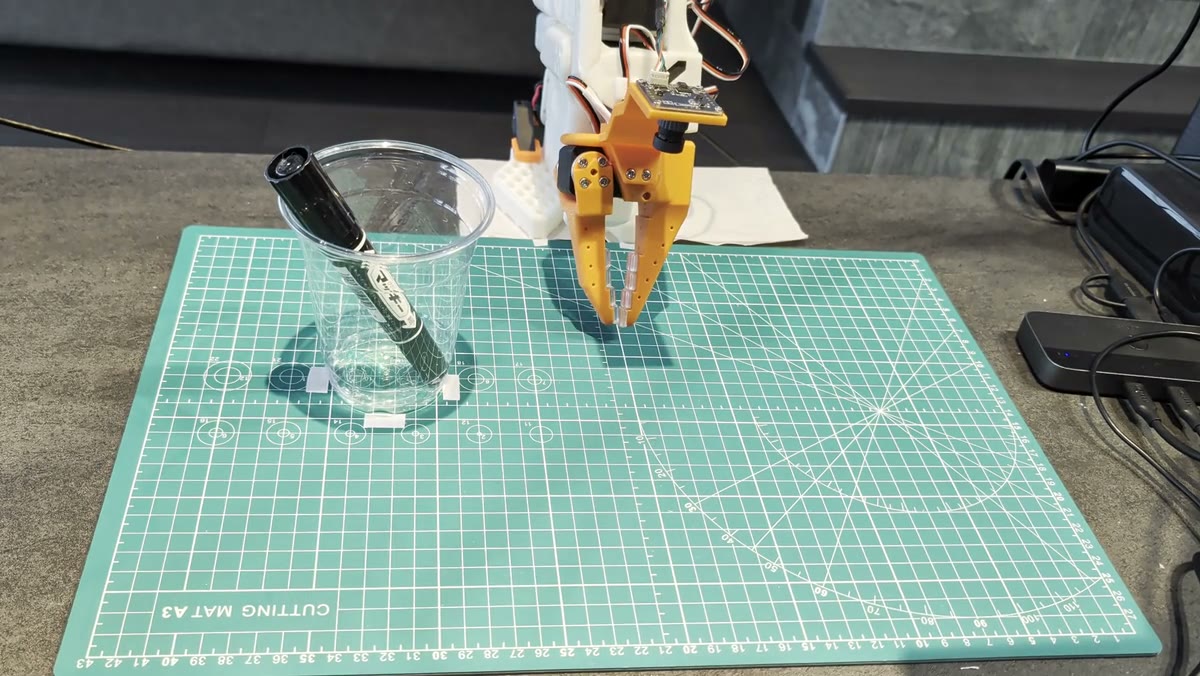
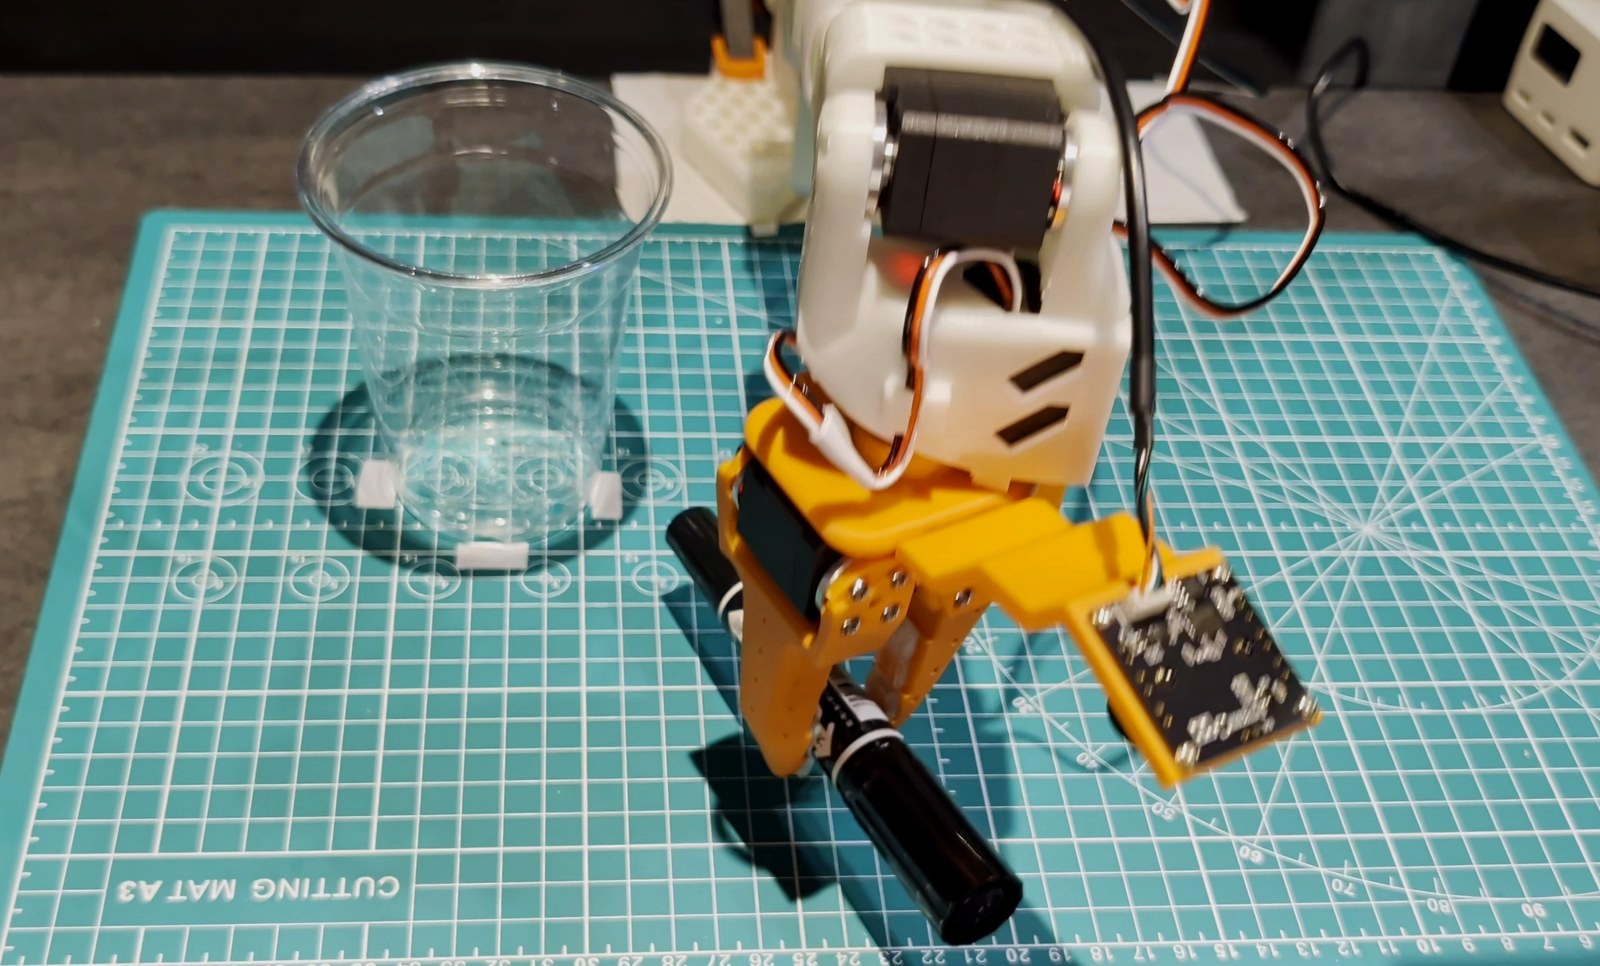
映像は実際の実験環境。学習を終えたばかりのモデルが、マーカーを掴んでコップへ — 途中で人が置き場所を変えても、追いかけて掴み直します。この一角のJetsonとアームに、ここまで説明したループがそのままつながっていて、結果は次の学習データになります。
上の映像から数日、エージェントが改善を重ねた結果がこれです。掴み損ねてもすぐに立て直し、コップまでの動きがひと続きになりました。ループが回り続けるかぎり、ロボットは上手くなり続けます。
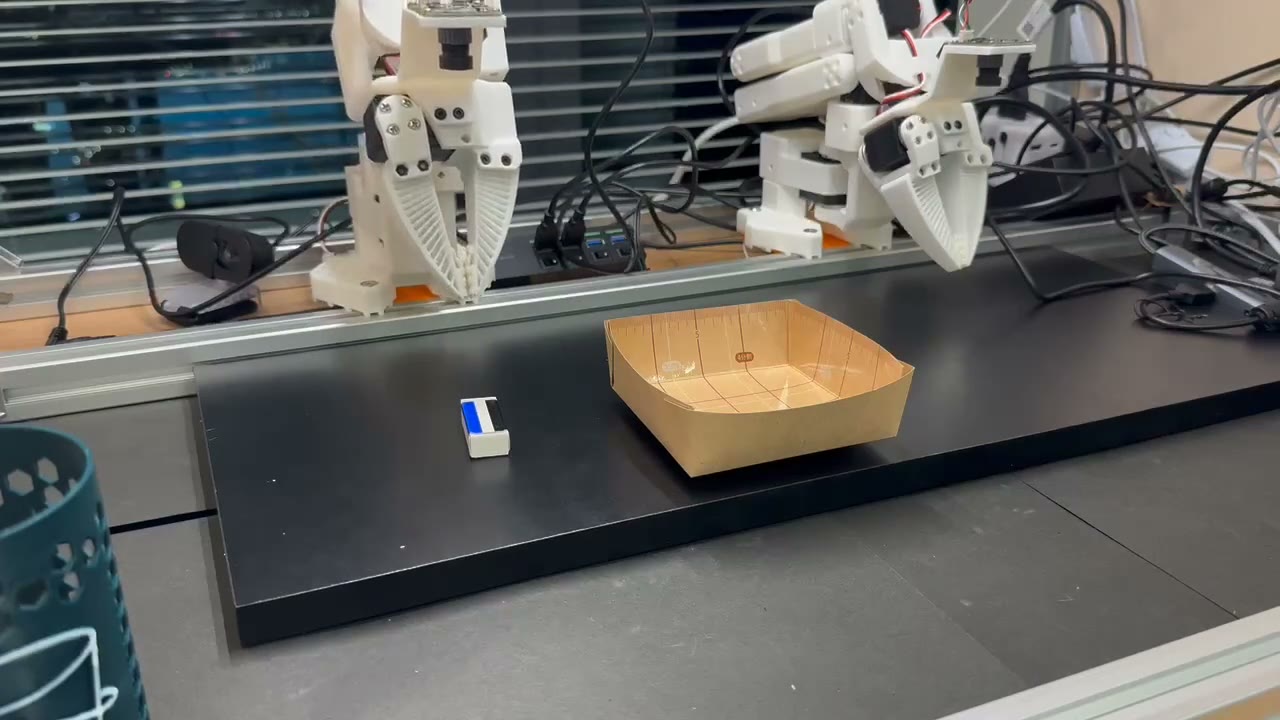
入れるだけだったロボットが、いまはカップから取り出して戻すところまでをひとつのモデルでこなします。「取り出す」お手本を集めて学び直した、ループのもう一周の成果です。
「入れる」と「取り出す」の2つのモデルを持ち、マットの状態を見てどちらを実行するかを自分で決めながら、片づけては取り出す往復を、人が席を離れたあとも自律で続けます。見守るのはKiro(AIエージェント)。うまくいったか、どこで時間がかかったかを記録し、次に集めるお手本の候補にしていく — 改善のループが人の手を離れ、ロボット自身のものになった姿です。
ログは実際の運用記録から抜粋・要約したものです。
AWS Services
Physical AIといっても、使うのは特別なサービスではありません。いつものAWSの組み合わせです。
Learn More